SEO

Qual a importacia do Robts.txr no seu blog? Entenda rastreamento, indexação e configuração para melhorar a visibilidade da sua empresa.

ClickHunt
Publicado
Atualizado
Tempo leitura
18 min
Áudio
23 min
Ouvir o artigo
Entender o robots.txt é essencial para orientar rastreadores, proteger o desempenho do site e evitar decisões de SEO que limitem a visibilidade do seu blog.
Resposta rápida
O robots.txt orienta os rastreadores sobre quais áreas do blog podem ser acessadas, ajudando a administrar o rastreamento e a reduzir requisições desnecessárias. Ele não é uma barreira de segurança nem garante que uma URL deixe de aparecer nos resultados de busca. Para funcionar corretamente, deve ser um arquivo de texto simples, chamado robots.txt, acessível na raiz do domínio. A configuração precisa refletir a estratégia do site: bloquear áreas realmente irrelevantes, preservar recursos importantes e acompanhar o comportamento das páginas depois da publicação.
O robots.txt orienta rastreadores, mas não substitui proteção por senha nem impede sozinho a indexação.
A localização correta é a raiz do domínio, com acesso público e nome exato robots.txt.
Regras específicas ajudam a concentrar o rastreamento no conteúdo relevante do blog.
Antes de publicar, revise maiúsculas, minúsculas, ordem das regras e caminhos afetados.
Depois da configuração, acompanhe rastreamento, indexação e desempenho para ajustar a estratégia.
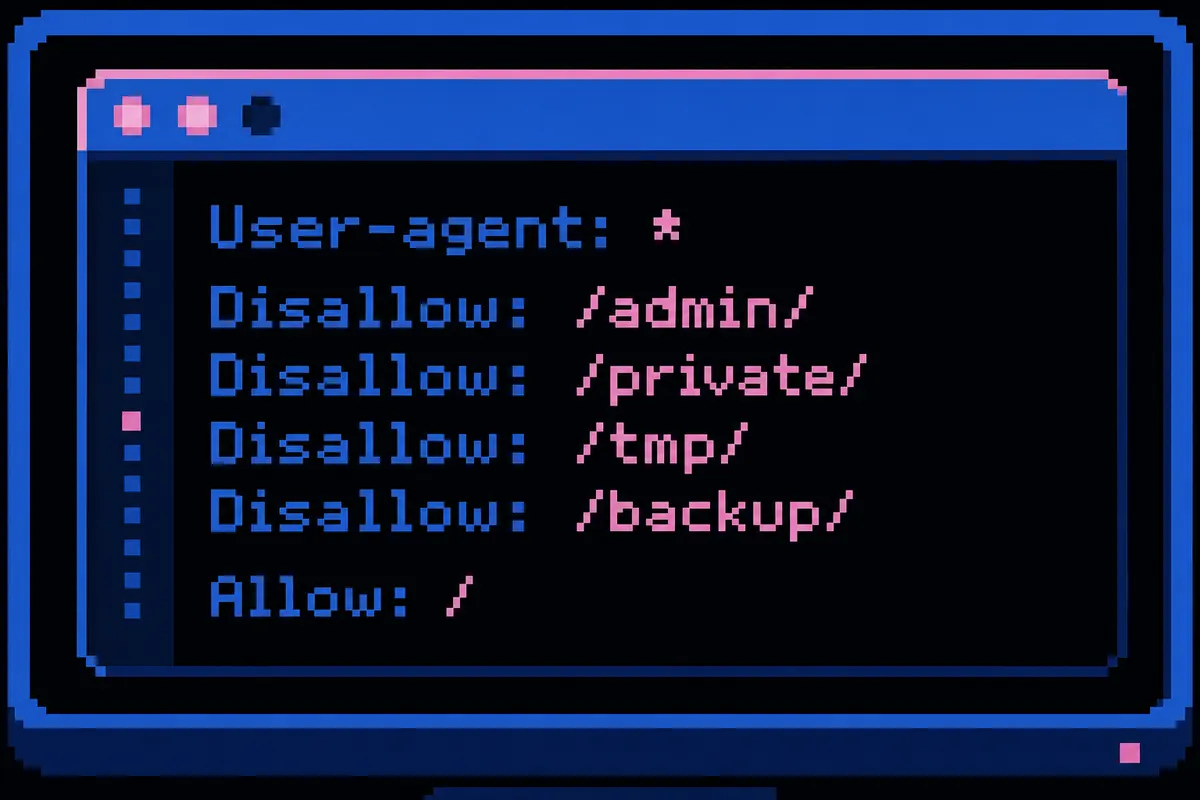
O robots.txt é um arquivo de texto simples que informa aos rastreadores quais caminhos do site podem ou não ser acessados durante o rastreamento. Ele funciona como uma orientação pública para robôs, não como uma barreira de segurança contra pessoas ou acessos mal-intencionados.
Quando uma empresa publica um blog, cada visita de um rastreador consome recursos do servidor e precisa ser direcionada para áreas que realmente contribuem para a descoberta do conteúdo. O robots.txt ajuda a organizar essa relação. Nele, a empresa pode indicar regras para determinados rastreadores e caminhos, evitando que áreas administrativas, filtros repetitivos ou arquivos sem valor para a busca recebam atenção desnecessária.
O arquivo deve ser um texto codificado em UTF-8. Ele segue o Padrão de Exclusão de Robôs, um protocolo estabelecido para comunicação entre sites e rastreadores. Seu nome precisa ser exatamente robots.txt, sem variações de maiúsculas e minúsculas. Também há uma característica estrutural importante: cada site pode ter apenas um arquivo robots.txt por origem. Um subdomínio, por sua vez, pode ter seu próprio arquivo, porque é tratado como uma origem diferente.
O robots.txt fica na raiz do site. Em um domínio como www.example.com, o endereço esperado é www.example.com/robots.txt. Essa localização permite que os rastreadores encontrem as instruções antes de percorrer outras áreas. O arquivo também deve estar publicamente acessível, pois um rastreador não consegue aplicar uma regra que não pode consultar.
É útil separar três conceitos que costumam ser confundidos. Rastreamento é a visita do robô a uma URL. Indexação é a decisão de armazenar e considerar o conteúdo para resultados de busca. Classificação é a posição que uma página pode alcançar. O robots.txt atua principalmente no primeiro ponto. Ele não oferece controle completo sobre os outros dois, e uma configuração inadequada pode criar obstáculos para a descoberta de páginas importantes.
A importância do robots.txt para SEO está em administrar o rastreamento, reduzir acessos desnecessários e direcionar a atenção dos robôs para o conteúdo que importa para o negócio. Ele é uma ferramenta de organização técnica, não um atalho para melhorar posições por si só.
Em blogs empresariais, é comum existirem páginas de busca interna, combinações de filtros, parâmetros de URL, áreas de login e versões semelhantes de um mesmo conteúdo. Nem todos esses endereços precisam ser visitados com a mesma frequência. Ao orientar o rastreamento, o robots.txt ajuda a evitar sobrecarga do site e reduz a chance de o robô gastar tempo com caminhos que não participam da estratégia editorial.
Essa gestão é especialmente útil quando o blog publica conteúdo com regularidade e possui muitas categorias, tags ou recursos técnicos. O objetivo não é esconder páginas importantes, mas criar uma hierarquia operacional. Artigos, imagens e arquivos necessários à interpretação da página devem permanecer acessíveis quando sua ausência prejudicar a compreensão do conteúdo pelo rastreador. Bloquear uma folha de estilo, um recurso visual ou um arquivo incorporado sem avaliar o impacto pode dificultar a leitura da página.
O arquivo também pode informar a localização do sitemap, facilitando a descoberta da estrutura editorial. Essa indicação não substitui links internos, qualidade de conteúdo ou arquitetura clara, mas conecta duas partes importantes da operação técnica: o sitemap apresenta URLs relevantes e o robots.txt define limites de acesso para rastreamento.
O histórico do protocolo ajuda a explicar sua relevância. O Robots Exclusion Protocol foi publicado inicialmente em 1994 e padronizado formalmente em 2022. A adoção ampla por operadores de robôs mostra que essas instruções são consideradas na rotina de rastreamento, embora não devam ser tratadas como mecanismo de segurança.
Quando criação, otimização e publicação seguem uma lógica integrada, as regras técnicas deixam de ser um arquivo esquecido e passam a apoiar a presença da empresa nos mecanismos de busca e nas IAs.
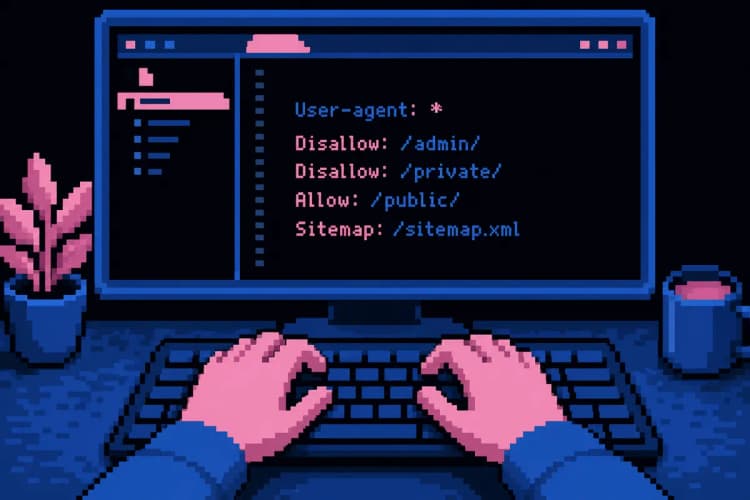
Para criar um robots.txt, produza um arquivo de texto simples, defina regras claras para os rastreadores, salve-o com o nome exato e publique-o na raiz do domínio. Depois, teste o comportamento esperado antes de considerar a configuração concluída.
A estrutura começa pela identificação do rastreador ao qual a regra se aplica, usando a diretiva User-agent. Em seguida, entram instruções como Disallow, para indicar caminhos que não devem ser rastreados, e Allow, quando uma exceção precisa ser explicitada. As regras são sensíveis a maiúsculas e minúsculas, portanto o caminho escrito deve corresponder ao caminho real do site.
A ordem também exige atenção. Os grupos de regras são processados de cima para baixo, e uma regra ampla pode produzir um efeito diferente daquele imaginado quando aparece antes de uma exceção. Por isso, a configuração deve ser lida como uma política: primeiro se define o alcance, depois se revisam os caminhos e, por fim, se confirmam as exceções necessárias.
O caractere curinga asterisco pode ser usado nas regras para representar padrões de caminho ou determinados rastreadores. A linha sitemap pode informar o endereço do mapa do site, mas não segue essa mesma lógica de curinga. Um modelo simples, sem bloquear conteúdo relevante, costuma ser mais seguro do que uma política extensa criada sem inventário das URLs.
Não use o robots.txt para esconder dados sensíveis, informações internas ou documentos que não deveriam estar publicamente disponíveis. Uma URL bloqueada pode continuar aparecendo nos resultados se for descoberta por links externos, ainda que sem descrição adequada. Para impedir de maneira apropriada que um endereço apareça, é necessário aplicar controle no servidor, como proteção por senha.
Antes de escrever qualquer regra, faça um inventário das áreas do blog. Separe conteúdo editorial, recursos necessários à renderização, páginas duplicadas, filtros, ambientes de teste e áreas administrativas. Essa preparação evita bloqueios acidentais e torna a manutenção compreensível para a equipe de marketing, desenvolvimento e SEO.
O teste deve confirmar tanto o que será permitido quanto o que será bloqueado. Use o relatório de robots.txt da ferramenta de monitoramento para verificar se um caminho é alcançável segundo as regras publicadas. A análise não termina ao observar uma única URL: compare páginas de artigo, arquivos de mídia, recursos usados no carregamento e áreas que realmente não precisam ser rastreadas.
Leia o arquivo como se fosse um rastreador. Confira se o nome está correto, se não existem caracteres estranhos, se as diretivas estão associadas ao User-agent pretendido e se a sequência de regras não cria uma exceção involuntária. Uma mudança pequena em um caminho pode afetar muitas páginas quando há uso de curinga.
Depois do upload, os rastreadores dos mecanismos de busca encontram e começam a usar automaticamente o arquivo acessível. Ainda assim, a equipe deve acompanhar os sinais do site. Se páginas estratégicas deixarem de ser rastreadas, recursos visuais não carregarem adequadamente para o robô ou o relatório apresentar bloqueios inesperados, reverta ou ajuste a regra com método.
O arquivo também possui limite operacional. O padrão exige que os rastreadores consigam interpretar pelo menos 500 kibibytes (512.000 bytes), e o limite é mantido para robots.txt. Na prática, regras objetivas e agrupadas facilitam a leitura e reduzem o risco de uma política excessivamente extensa.
O arquivo deve ficar na raiz do domínio, com o endereço público formado pelo domínio seguido de /robots.txt. Não o coloque dentro da pasta de artigos, em uma categoria ou em um diretório administrativo. Se a empresa usa subdomínios, cada origem pode ter sua própria configuração, e o efeito de uma regra precisa ser avaliado no endereço em que ela foi publicada.
A publicação só cumpre seu papel quando o arquivo pode ser consultado externamente. Depois de salvar, abra o endereço público e confirme que o servidor entrega o texto correto, sem exigir autenticação ou redirecionar para uma página que não contenha as regras. Também confira se uma camada de cache não está exibindo uma versão antiga após a atualização.
Em uma plataforma de blog, o procedimento normal, depois de habilitar o robots.txt personalizado, é acessar Configurações, abrir a área de rastreadores e indexação e ativar a opção de robots.txt personalizado. A partir daí, a equipe deve inserir regras alinhadas ao inventário do blog, evitando copiar configurações genéricas sem entender seus efeitos.
A localização correta é simples, mas decisiva. Um arquivo bem escrito em uma pasta errada não orienta a origem principal. Da mesma forma, um arquivo na raiz com bloqueios amplos pode limitar o rastreamento de páginas que sustentam a aquisição orgânica. Publicação e revisão precisam caminhar juntas.
Mapeie as áreas do blog e classifique o que é estratégico, repetitivo, administrativo ou sensível.
Escreva regras específicas para os rastreadores e caminhos que realmente precisam de orientação.
Salve o arquivo com o nome robots.txt e publique-o na raiz do domínio correspondente.
Teste URLs permitidas e bloqueadas no relatório de robots.txt da ferramenta de monitoramento.
Acompanhe o rastreamento após a publicação e documente cada alteração feita pela equipe.
Sem um robots.txt, os arquivos do site ficam implicitamente permitidos para rastreamento, salvo quando outras instruções ou mecanismos do servidor produzirem efeito. Isso não significa necessariamente um problema, mas elimina uma camada de organização do tráfego de robôs.
Para um blog pequeno e totalmente público, permitir o rastreamento pode ser compatível com a estratégia. Se a empresa quer que todo o conteúdo seja rastreado e não possui áreas repetitivas ou restritas, a ausência do arquivo não impede automaticamente a descoberta das páginas. O risco aparece quando o site cresce e ninguém revisa quais caminhos estão consumindo recursos.
Sem orientações, rastreadores podem visitar parâmetros, filtros, páginas de pesquisa interna, arquivos antigos sem valor e combinações que produzem versões semelhantes do conteúdo. Isso pode aumentar requisições ao servidor e dificultar a concentração do rastreamento nas páginas que representam produtos, serviços, conhecimento e oportunidades comerciais.
Também há um risco de gestão. Quando a equipe não declara uma política de rastreamento, cada mudança de arquitetura pode gerar comportamento inesperado. Uma nova área administrativa, um ambiente de testes exposto ou uma estrutura de filtros pode ser percorrida sem que marketing e tecnologia percebam o impacto.
A ausência do arquivo não protege nem desprotege uma página por si só em termos de indexação. O ponto central é que a empresa perde uma forma pública e organizada de orientar rastreadores. A decisão deve considerar o desenho real do site, o volume de URLs e a importância de preservar recursos do servidor.
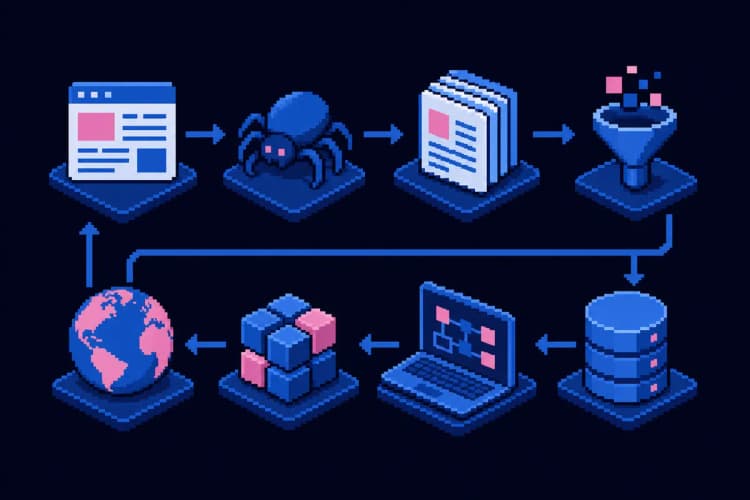
O robots.txt afeta a indexação de forma indireta: ele controla o acesso do rastreador a URLs, mas não é o mecanismo adequado para impedir que uma página apareça nos resultados. Uma URL bloqueada ainda pode ser descoberta por links e aparecer sem uma descrição completa.
Essa distinção é indispensável para evitar erros de SEO. Quando uma página está bloqueada, o rastreador pode não ler seu conteúdo, seus links e seus recursos incorporados. Se a URL for mencionada em outros locais, porém, o buscador ainda pode saber que ela existe. Nesse caso, a página pode aparecer no resultado sem o contexto que a equipe esperava oferecer.
Imagens, vídeos, PDFs e outros arquivos que não são HTML, quando incorporados em uma página bloqueada, também podem deixar de ser rastreados. Se esses recursos forem necessários para que o rastreador compreenda o conteúdo, bloqueá-los pode piorar a interpretação da página. A revisão deve considerar a função do arquivo, não apenas seu formato ou localização.
Para controlar a participação de uma página nos resultados, use o mecanismo apropriado no próprio site ou no servidor, conforme o objetivo técnico. Se o problema for confidencialidade, uma proteção de acesso é mais adequada do que uma regra pública de robots.txt. O arquivo foi criado para administrar rastreamento, não para esconder informações de quem consegue encontrar a URL.
A indexação também depende de sinais que não estão no robots.txt, como links, conteúdo, respostas do servidor e políticas aplicadas à página. Por isso, uma auditoria deve separar o diagnóstico de rastreamento do diagnóstico de indexação. Essa separação reduz correções erradas e evita bloquear justamente uma página que a empresa deseja tornar visível.
No planejamento editorial, trate o robots.txt como uma fronteira de eficiência. Ele pode ajudar o robô a priorizar o que é relevante, mas a visibilidade do blog depende de uma combinação mais ampla entre arquitetura, conteúdo útil, ligações internas e manutenção técnica.
Ativar o robots.txt personalizado significa substituir ou editar as instruções padrão do ambiente de publicação para definir uma política própria de rastreamento. A ativação só deve ocorrer quando a equipe entende os caminhos que deseja orientar e consegue revisar o efeito das regras.
Em uma plataforma de blog, a opção personalizada dá mais controle sobre o texto que será entregue aos rastreadores. Isso é útil quando o padrão da plataforma não representa a arquitetura do site, quando há filtros que geram muitas URLs ou quando o negócio precisa apontar seu sitemap. Ao mesmo tempo, mais controle exige mais responsabilidade: uma diretiva ampla pode atingir artigos, categorias e recursos que sustentam a experiência da página.
Em uma plataforma de blog, o caminho normal passa por Configurações, pela seção de rastreadores e indexação e pela opção de robots.txt personalizado. A interface pode mudar com o tempo, por isso a equipe deve confirmar o endereço público após salvar e validar o resultado no relatório de teste. O mais importante não é apenas ligar a opção, mas publicar uma política coerente com o objetivo do blog.
Antes de ativar, registre a configuração atual e faça uma cópia do texto que será publicado. Depois, valide as páginas prioritárias, os recursos de carregamento e os caminhos que não devem ser visitados. Uma revisão feita por alguém que conheça a arquitetura reduz o risco de transformar um ajuste técnico em queda de descoberta orgânica.
Se o site não precisa bloquear nenhum caminho e a intenção é deixar todo o conteúdo rastreável, os mecanismos de busca indicam que não é necessário criar um robots.txt. Até um arquivo vazio pode ser dispensado nesse cenário. A personalização deve resolver uma necessidade concreta, não existir apenas porque a plataforma oferece a opção.
Configurar o robots.txt é apenas o começo. O próximo passo é transformar a regra publicada em uma rotina de controle, conectando tecnologia, conteúdo e metas de aquisição. Comece documentando quais caminhos foram permitidos, quais foram bloqueados e qual motivo estratégico justificou cada decisão. Esse registro evita que uma alteração futura seja feita sem compreender o impacto acumulado.
Em seguida, confronte o arquivo com o sitemap e com os links internos do blog. URLs apresentadas como importantes precisam ser alcançáveis pelos rastreadores e receber caminhos claros dentro da arquitetura. Se o sitemap aponta páginas que a política bloqueia, há uma contradição operacional que deve ser resolvida antes de avaliar desempenho.
Acompanhe o relatório de robots.txt na ferramenta de monitoramento e observe sinais de rastreamento, páginas estratégicas descobertas e recursos que deixaram de ser acessados. Faça a mesma leitura quando publicar uma nova categoria, alterar filtros, migrar o site ou mudar a estrutura de URLs. O arquivo é pequeno, mas seus efeitos podem alcançar uma parte ampla do blog.
Também vale revisar o conteúdo que recebe prioridade. Um robots.txt bem configurado não corrige artigos pouco úteis, títulos imprecisos ou uma jornada comercial confusa. Ele cria condições técnicas para que o conteúdo certo seja encontrado. A equipe precisa combinar essa base com produção editorial consistente, otimização na página e links internos que conduzam o visitante para soluções relacionadas.
Para empresas que publicam em escala, a automação pode reduzir tarefas repetitivas de criação, otimização e publicação, desde que exista governança sobre as regras técnicas.
Por fim, conecte o monitoramento técnico aos resultados comerciais. Observe quais conteúdos atraem visitas qualificadas, quais páginas conduzem a oportunidades e onde a descoberta orgânica encontra barreiras. Quando a configuração do robots.txt, a produção de conteúdo e a análise de desempenho seguem a mesma direção, o blog se torna um ativo mais previsível para visibilidade e geração de demanda.
Documente as regras publicadas e o motivo de cada bloqueio ou permissão.
Compare robots.txt, sitemap, links internos e páginas estratégicas.
Teste novamente após mudanças de plataforma, arquitetura ou URLs.
Monitore rastreamento, indexação e desempenho comercial em uma rotina contínua.
Ajuste a operação de conteúdo sem bloquear recursos necessários à compreensão das páginas.
Reduzir rastreamento de filtros, parâmetros e áreas repetitivas → Mapeie esses caminhos e crie regras específicas, preservando artigos e recursos necessários à renderização.
Impedir que uma informação sensível apareça nos resultados → Não dependa do robots.txt; aplique proteção de acesso no servidor ou outro mecanismo adequado.
Permitir que todo o conteúdo público seja rastreado → Mantenha a política simples e considere dispensar o arquivo quando não houver necessidade de orientação.
Ativar regras próprias em um blog Blogger → Habilite o robots.txt personalizado nas configurações de rastreadores e indexação, publique com cautela e teste o endereço.
Usar o blog como canal contínuo de aquisição → Combine revisão técnica do robots.txt com produção, otimização e publicação consistentes, acompanhando descoberta e desempenho.
Empresa com blog pequeno e totalmente público: Mantenha o rastreamento aberto e evite regras personalizadas sem uma necessidade concreta.
Empresa com muitas URLs, filtros ou páginas semelhantes: Use regras específicas para administrar o rastreamento e proteger recursos do servidor.
Empresa que precisa ocultar conteúdo sensível: Escolha proteção de acesso no servidor, pois robots.txt não é controle de segurança.
Empresa que publica conteúdo em escala: Integre revisão técnica, monitoramento e automação de conteúdo em uma rotina documentada.
Não. Se todo o conteúdo deve ser rastreado e não há necessidade de orientar caminhos específicos, o Google indica que não é necessário ter um arquivo, inclusive vazio. Ainda assim, uma política bem documentada pode ser útil quando o site possui áreas repetitivas, filtros ou recursos que exigem gestão de rastreamento.
Não necessariamente. Ele controla o rastreamento, mas uma URL bloqueada pode ser descoberta por links e aparecer sem uma descrição completa. Para impedir adequadamente a exibição, use mecanismos de controle no servidor ou na própria página, conforme o objetivo técnico.
Na raiz do domínio, com acesso público e nome exato robots.txt. O endereço esperado segue o formato do domínio seguido por /robots.txt. Em um subdomínio, a origem pode ter sua própria configuração.
Não. O arquivo é público e não deve ser tratado como mecanismo de segurança. Conteúdos sensíveis precisam de proteção de acesso no servidor, como autenticação ou senha.
O rastreador pode deixar de acessar esses recursos e ter mais dificuldade para compreender ou renderizar o conteúdo. Antes de bloquear, confirme se a imagem, o vídeo, o PDF ou outro arquivo é necessário para a interpretação da página.
Consulte o relatório de robots.txt no Search Console, teste caminhos permitidos e bloqueados e confirme o arquivo no endereço público. Também acompanhe o rastreamento depois da publicação para encontrar efeitos inesperados.
Sim. O arquivo pode incluir uma linha com a localização do sitemap. Essa indicação ajuda a conectar a política de rastreamento à estrutura de URLs que a empresa deseja apresentar aos rastreadores.
Significa habilitar a edição das instruções de rastreamento dentro das configurações da plataforma. O caminho normal passa por Configurações, pela área de rastreadores e indexação e pela opção de robots.txt personalizado. Depois, o conteúdo deve ser revisado e testado.

Escrito por
Mariana RiosClickHunt
Escrevo sobre IA, conteúdo e como fazer marcas aparecerem no Google, ChatGPT, Gemini e Perplexity. No ClickHunt, transformo automação e estratégia em conteúdo que trabalha mesmo quando a gente não está.